跳到主要内容
AI工具库
AI智能体AI办公工具AI图像工具AI视频工具Token服务资讯
  1. 首页
  2. AI模型评测
  3. Open LLM Leaderboard
INDEX · #318AI模型评测

Open LLM Leaderboard

huggingface.co

Hugging Face推出的开源大模型排行榜单

访问官网 ↗ 更多同类工具
网站截图 · 仅供参考在新标签打开官网↗
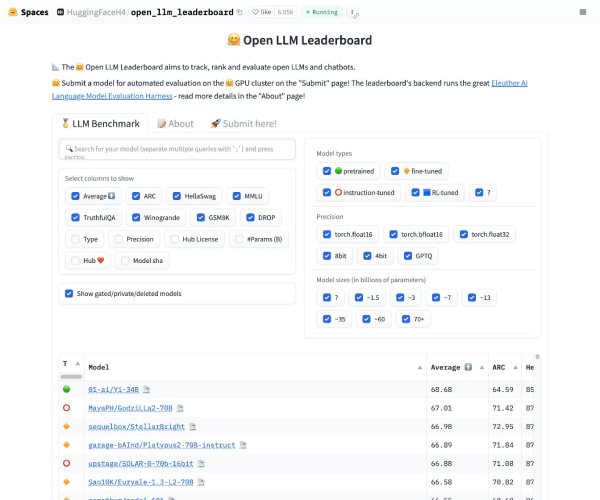
Open LLM Leaderboard 官网首页截图

官网首页截图/收录于 2025/05/03

评分
暂无还没有人评分
定价
未标注以官网为准
浏览
660 次访问
收录
2025/05/03暂无检查记录

工具介绍

关于 Open LLM Leaderboard 的定位、能力与适用场景

DOSSIER

Open LLM Leaderboard 是最大的大模型和数据集社区 HuggingFace 推出的开源大模型排行榜单,基于 Eleuther AI Language Model Evaluation Harness(Eleuther AI语言模型评估框架)封装。

由于社区在发布了大量的大型语言模型(LLM)和聊天机器人之后,往往伴随着对其性能的夸大宣传,很难过滤出开源社区取得的真正进展以及目前的最先进模型。因此,Hugging Face 使用 Eleuther AI语言模型评估框架对模型进行四个关键基准测试评估。这是一个统一的框架,用于在大量不同的评估任务上测试生成式语言模型。

Open LLM Leaderboard 的评估基准

  • AI2 推理挑战(25-shot):一组小学科学问题
  • HellaSwag(10-shot):一个测试常识推理的任务,对人类来说很容易(大约95%),但对SOTA模型来说具有挑战性。
  • MMLU(5-shot)- 用于测量文本模型的多任务准确性。测试涵盖57个任务,包括基本数学、美国历史、计算机科学、法律等等。
  • TruthfulQA(0-shot)- 用于测量模型复制在在线常见虚假信息中的倾向性。
收录说明

收录不代表推荐,请结合自己的工作流与预算做最终判断。

Open LLM Leaderboardhuggingface.co
访问官网 ↗

将在新标签页打开 huggingface.co

分类
AI模型评测
定价
未标注
评分
暂无
浏览
66
收录
2025/05/03
检查
暂无检测记录
官网
huggingface.co

Same category

同类工具

查看 AI模型评测 全部 →

PubMedQA

pubmedqa.github.io
访问官网↗

生物医学研究问答数据集和模型得分排行榜

AI模型评测

H2O EvalGPT

h2o.ai
访问官网↗

H2O.ai推出的基于Elo评级方法的大模型评估系统

AI模型评测

LLMEval3

github.com
访问官网↗

由复旦大学NLP实验室推出的大模型评测基准

AI模型评测

Chatbot Arena

lmarena.ai
访问官网↗

以众包方式进行匿名随机对战的LLM基准平台

AI模型评测

HELM

crfm.stanford.edu
访问官网↗

HELM全称Holistic Evaluation...

AI模型评测

MMBench

mmbench.opencompass.org.cn
访问官网↗

全方位的多模态大模型能力评测体系

AI模型评测

CMMLU

github.com
访问官网↗

一个综合性的大模型中文评估基准

AI模型评测

司南OpenCompass

rank.opencompass.org.cn
访问官网↗

上海人工智能实验室推出的大模型开放评测体系

AI模型评测
Open LLM Leaderboardhuggingface.co
访问 ↗
AI工具库

一份持续更新的 AI 与数字工具索引,记录真正值得使用的东西。

Q
Q群二维码
微
微信二维码

分类

AI智能体AI写作工具AI办公工具AI内容检测AI图像工具AI学习网站AI对话聊天AI开发框架AI提示词AI搜索引擎AI模型评测AI法律助手AI编程工具AI视频工具AI训练模型AI设计工具AI音频工具Token服务

关于

关于AI工具库导航免责声明RSS 订阅

说明

所有外部链接经由站内跳转打开并统计点击,收录不代表推荐。

© 2026 AI工具库回到顶部 ↑
独立编辑 · 持续更新