工具介绍
关于 MMBench 的定位、能力与适用场景
MMBench是一个多模态基准测试,由上海人工智能实验室、南洋理工大学、香港中文大学、新加坡国立大学和浙江大学的研究人员推出。该体系开发了一个综合评估流程,从感知到认知能力逐级细分评估,覆盖20项细粒度能力,从互联网与权威基准数据集采集约3000道单项选择题。打破常规一问一答基于规则匹配提取选项进行评测,循环打乱选项验证输出结果的一致性,基于ChatGPT精准匹配模型回复至选项。
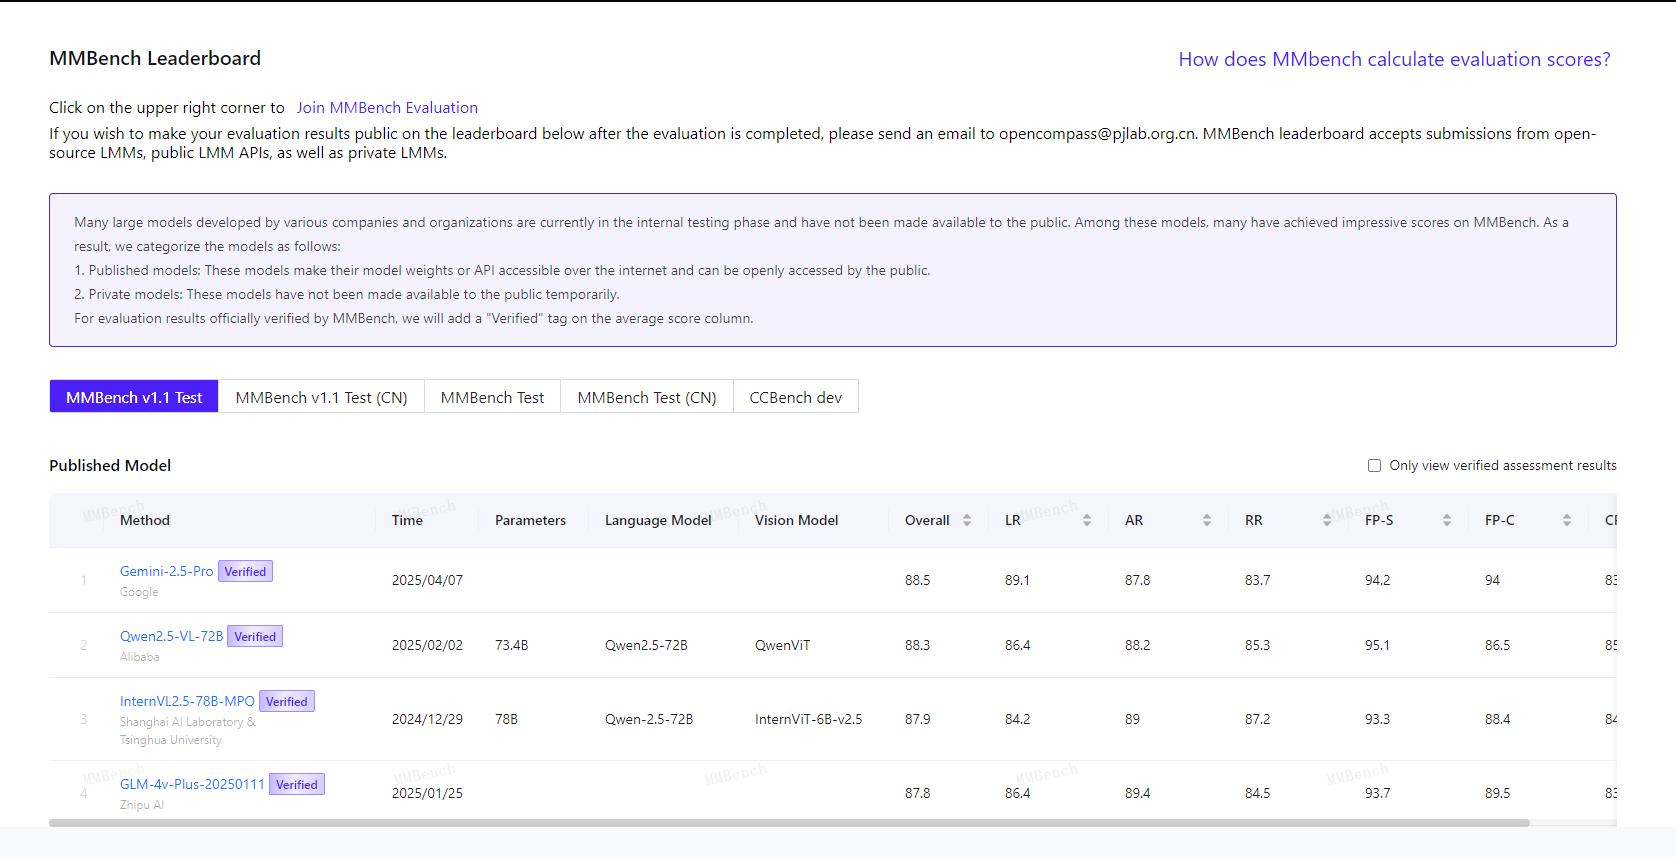
官网首页截图收录于 2025/05/03
关于 MMBench 的定位、能力与适用场景
MMBench是一个多模态基准测试,由上海人工智能实验室、南洋理工大学、香港中文大学、新加坡国立大学和浙江大学的研究人员推出。该体系开发了一个综合评估流程,从感知到认知能力逐级细分评估,覆盖20项细粒度能力,从互联网与权威基准数据集采集约3000道单项选择题。打破常规一问一答基于规则匹配提取选项进行评测,循环打乱选项验证输出结果的一致性,基于ChatGPT精准匹配模型回复至选项。
收录不代表推荐,请结合自己的工作流与预算做最终判断。
生物医学研究问答数据集和模型得分排行榜
H2O.ai推出的基于Elo评级方法的大模型评估系统
由复旦大学NLP实验室推出的大模型评测基准
以众包方式进行匿名随机对战的LLM基准平台
HELM全称Holistic Evaluation...
一个综合性的大模型中文评估基准
上海人工智能实验室推出的大模型开放评测体系
AI大模型评测社区