坦率的讲,看到这条消息的时候我还是愣了一下。
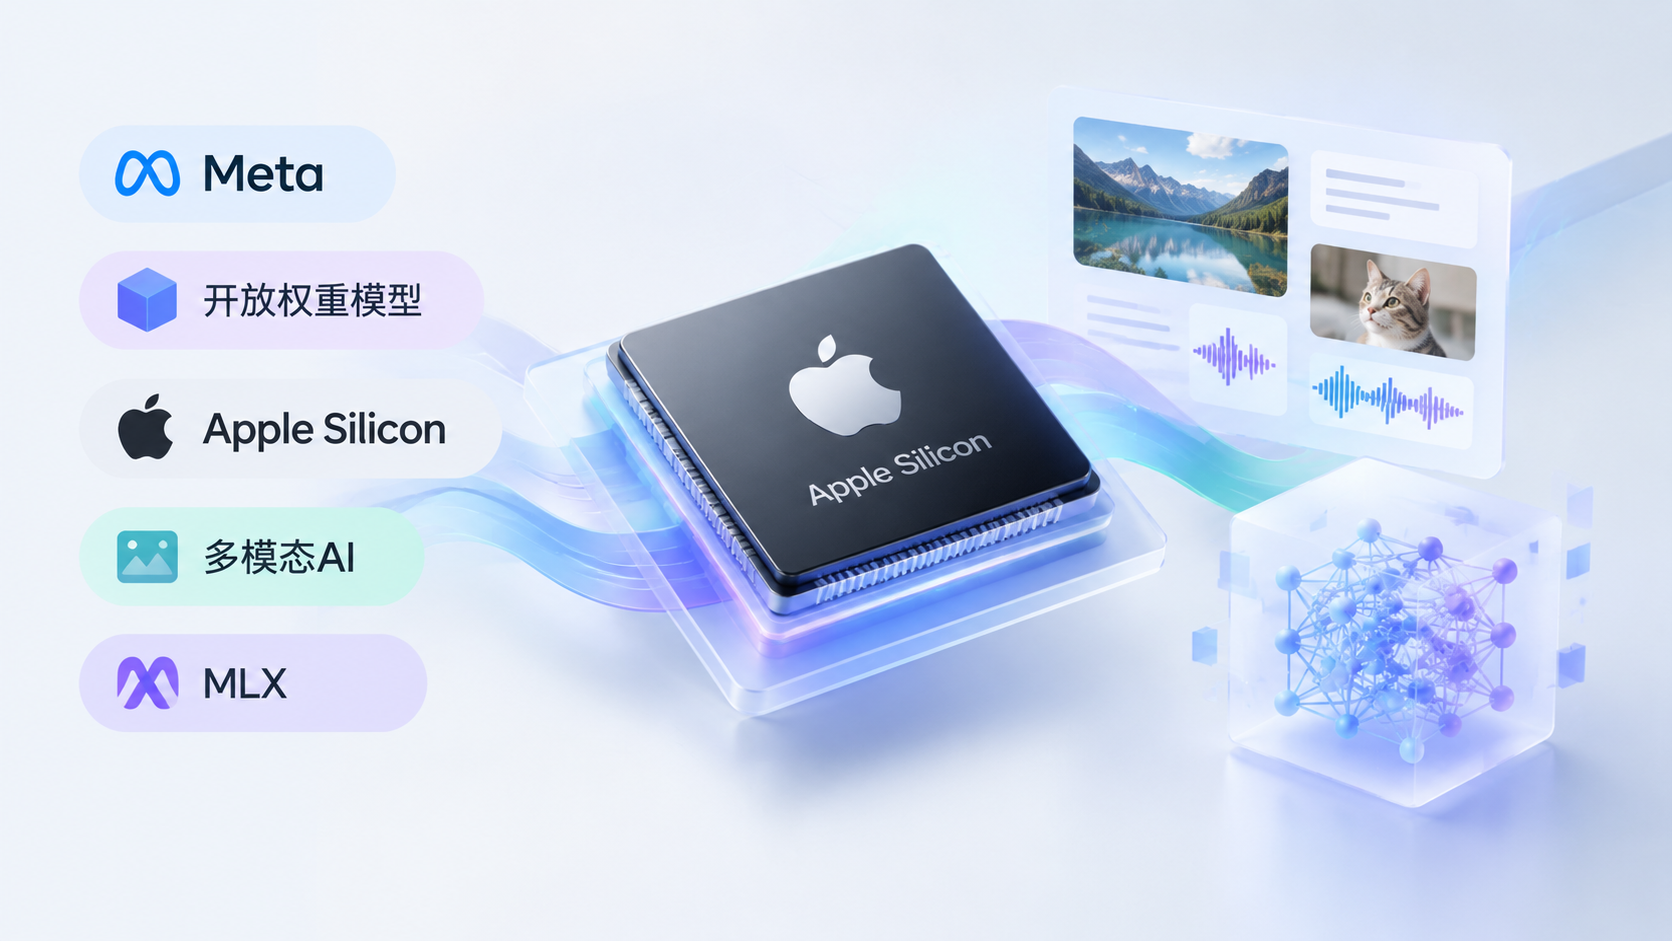
Meta 放出了一个叫 Muse Spark Open 的开放权重模型,官方给它的定位很直接,目前美国最强大的开放权重模型。多模态,总参数 8160 亿,激活参数 420 亿,支持 100 万 Token 的上下文长度。光这几个数字摆出来,已经够让不少做本地部署的人心里一紧了。
但真正让我觉得有意思的,不是参数规模本身,而是它跑在哪台机器上。
这个模型利用了苹果最新版的开源数组框架 MLX,专门针对 Apple Silicon 的统一内存架构做了优化,能跑在搭载 M5 Ultra 芯片的 Mac Studio 上。M5 Ultra 最大支持 512GB 内存,两台顶配 Mac Studio 拼一起,就相当于一台 1TB 统一内存的计算机,刚好能装下整个模型。你想想看,过去要跑这种级别的开放权重模型,基本得找一张甚至一组顶级数据中心 GPU,现在两台桌面工作站就够用了。这个门槛的落差,说实话有点夸张。
模型已经挂在了 Hugging Face 上,任何人都可以直接拉下来玩。这就意味着,开放权重这条路,Meta 这次是真的在把生态往消费级硬件上推。不是画饼说,开放权重未来可以跑在本地,而是直接给了一份针对 Apple Silicon 的优化实现,让 Mac 用户第一次有机会在自家桌面上跑一个八千亿级别的模型。
回到开放权重这件事本身。过去几年,开放权重模型的能力一直被闭源旗舰模型压着走,差距不是几个月,是几代。Muse Spark Open 这次把 8160 亿参数、多模态、百万上下文这三样打包放进开放权重里,再加上对消费级芯片的适配,其实是把开放权重生态的天花板往上顶了一大截。对研究者和独立开发者来说,这意味着你不需要再依赖某家大厂的 API,就可以在本地做实验、做微调、做私有部署,而且硬件成本不再是天文数字。
当然,开放权重不意味着完全无限制,具体的使用条款得去看 Meta 那边给出的 license,这块我没展开细说,但大概率不会是无限制商用。
最后说一句,信息来源是奇客 Solidot,原文标题是 Meta 发布其开放权重模型 Muse Spark Open。
相关文章