## 从“单模态”到“全感知”:Gemini 4 的跨模态跃迁
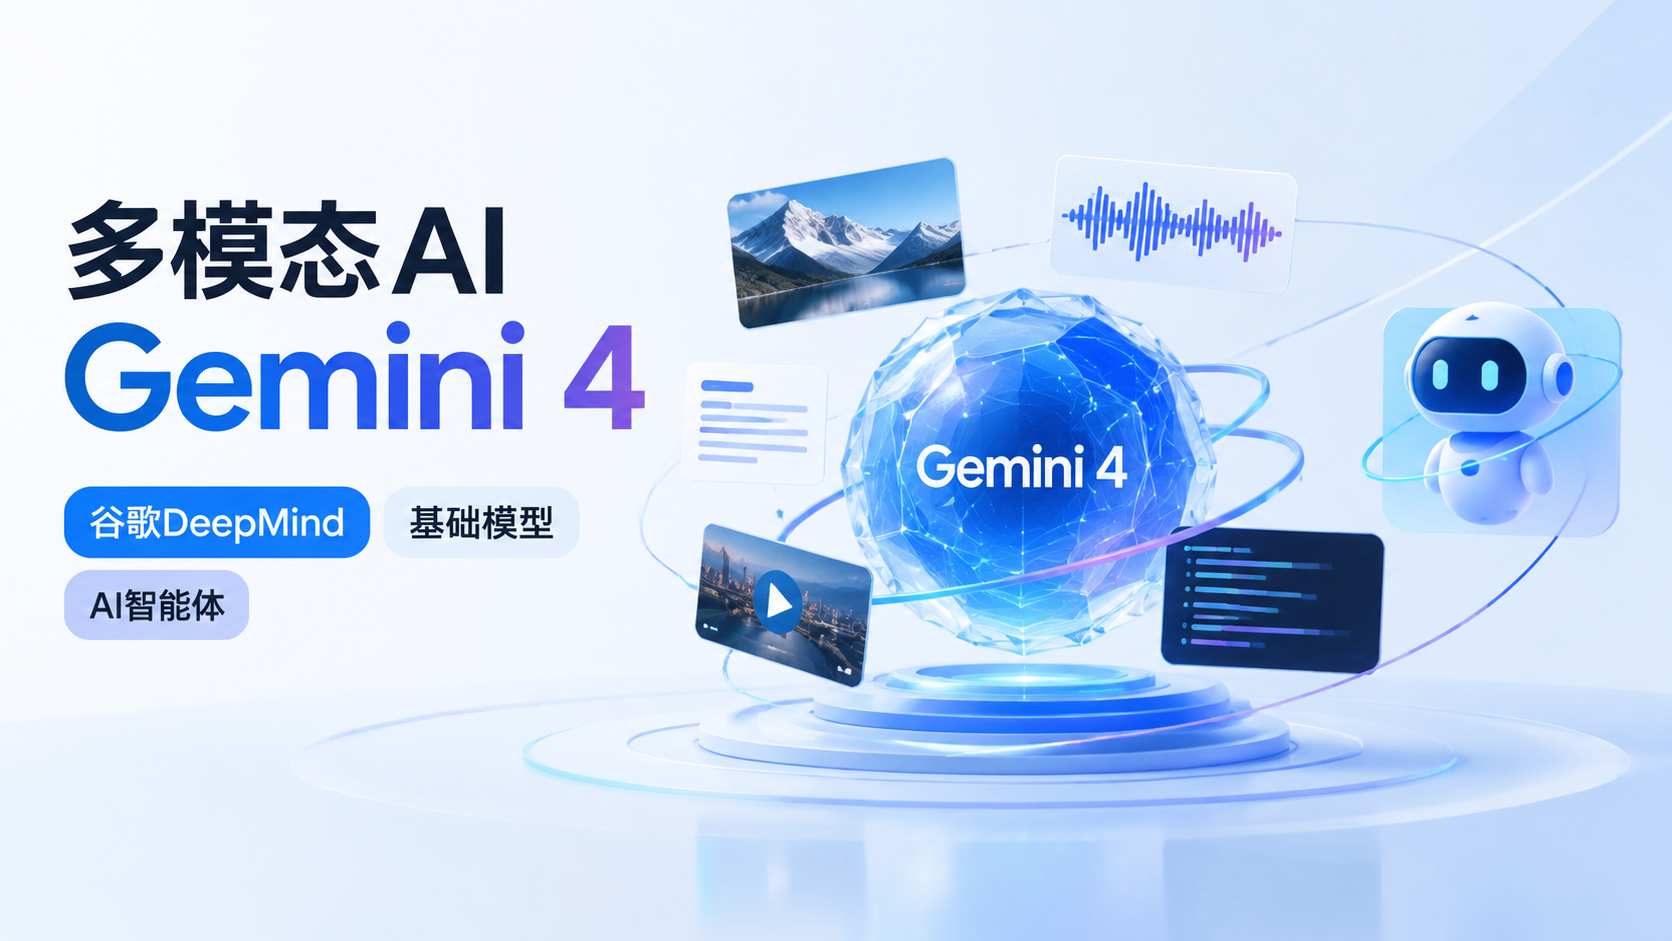
在人工智能的演进史上,每一次基础模型的迭代都标志着一场认知范式的转移。谷歌 DeepMind 最新发布的 Gemini 4(代号 Argon)并非简单的版本升级,而是对“多模态”概念的一次深度重构。如果说前几代模型主要在处理“信息”,那么 Gemini 4 开始处理“世界”。
这次更新最引人注目的特征,是其原生多模态架构的深度融合。传统 AI 模型往往将文本、图像、音频作为独立模态通过接口拼接,而 Gemini 4 在底层架构上实现了这些模态的统一表征。这意味着,模型不再需要“翻译”一张图表为文本后再进行推理,而是直接理解像素背后的逻辑、波形中的情绪以及三维空间中的物体关系。
## “Create anything from anything”的工程实践
在 DeepMind 的产品矩阵中,Gemini Omni 提出了“从任何事物创造任何事物”的愿景。这不仅仅是一句营销口号,其背后是基础模型对长上下文窗口与因果推理能力的极致压榨。
例如,结合专项模型 Veo 和 Lyria,Gemini 4 的基础能力允许开发者构建能够实时生成电影级视频并同步生成高保真音乐音轨的应用。更深层的变化在于 Gemini Robotics 的推出。通过让 AI 基础模型介入机器人感知层,AI 不再仅仅存在于屏幕之中,而是通过“感知-推理-工具使用-交互”的闭环,拥有了物理身体的潜在可能性。这种从数字到物理的延伸,是多模态 AI 发展的必然终点。
## 观点:基础模型的“智能体”化趋势
笔者认为,Gemini 4 的核心价值在于其向“智能体(Agent)”形态的靠拢。当模型能够原生处理视频流、控制音频设备并理解机器人传感器数据时,它就不再是一个被动的问答引擎,而是一个具备环境适应性的行动者。
这种能力也带来了新的挑战。当 AI 能够通过多模态数据理解我们的真实世界时,隐私边界和伦理安全防线必须随之升级。谷歌虽然强调了负责 AI 的重要性,但如何在使用端和部署端平衡“全感知”带来的便利性及其潜在风险,将是行业接下来的核心命题。
随着 AlphaEarth 在地球映射和 AlphaGenome 在基因组研究中的突破,Gemini 4 的基础多模态能力正成为科学发现的加速器。AI 正在从工具转变为伙伴,从单一介质走向万物互联。
相关文章