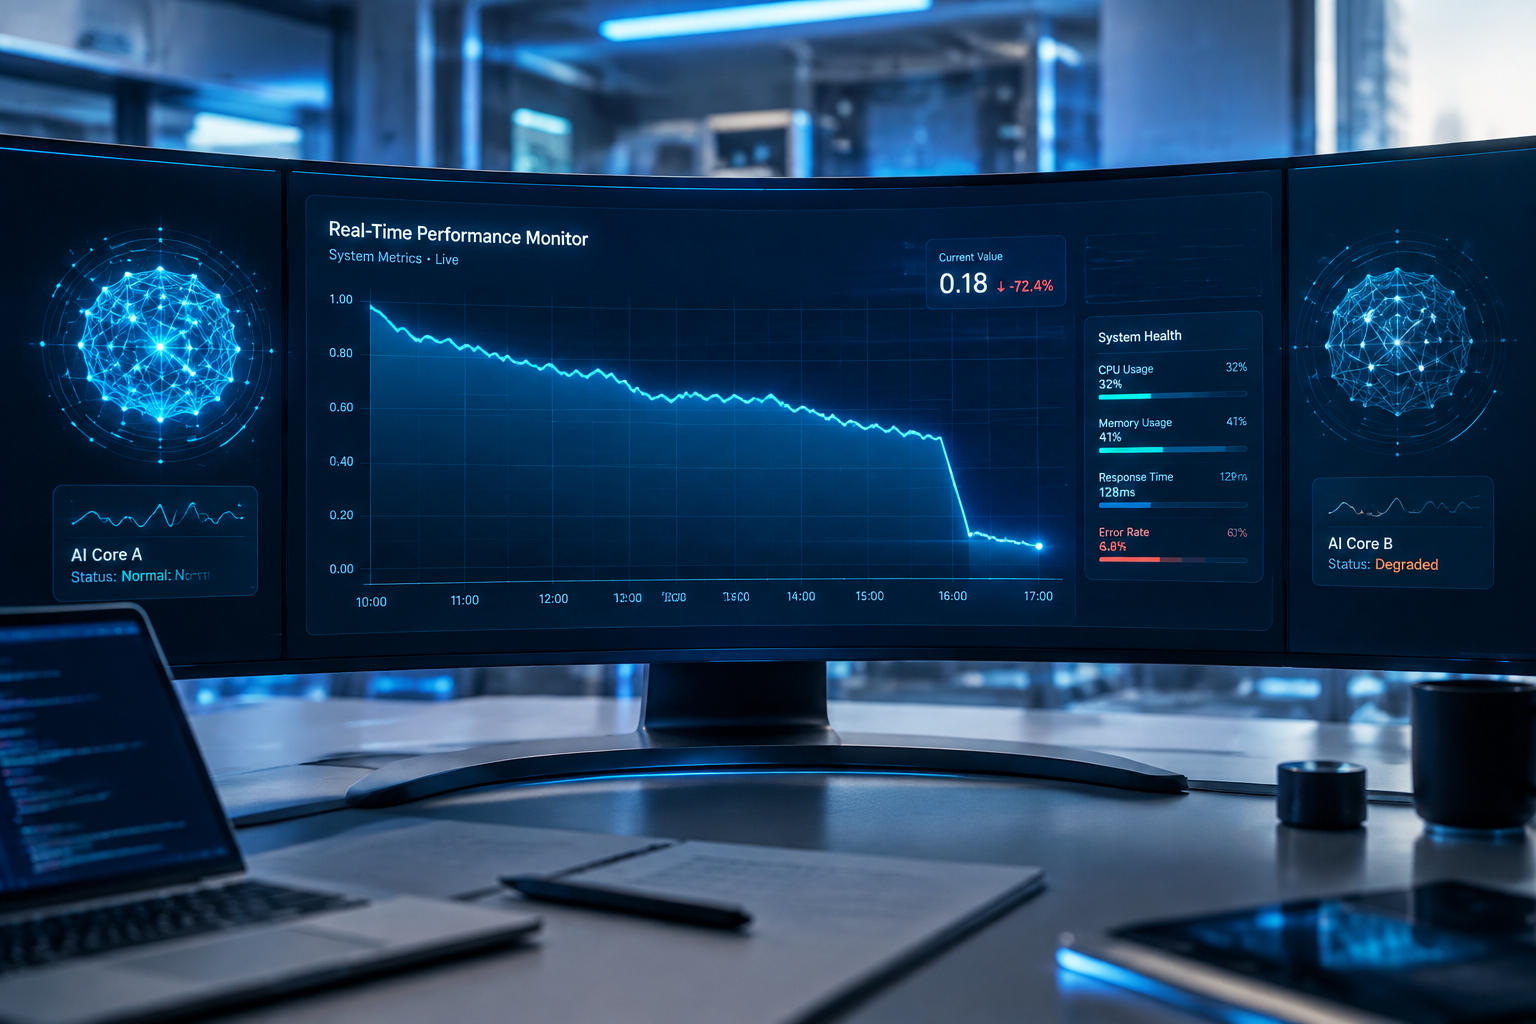
每次大模型发布,厂商都会在官方渠道摆出一组光鲜亮丽的基准测试数据。但模型一旦上线,随着用户量的激增、硬件资源的紧张,或者厂商出于成本控制的目的悄悄调整模型参数,其真实能力往往会发生不可预知的漂移。我们如何知道今天使用的大模型,还是发布时那个“全能版本”吗?
这正是开源项目“Livenerf”试图解决的问题。Livenerf并非仅仅记录模型发布时刻的静态基准,而是一个实时追踪工具。它的核心逻辑非常直观:在模型持续上线和运行的过程中,不断向其投递一组标准化、可量化的测试任务(例如代码编写、复杂推理、长文本总结),并将结果持续记录下来。通过绘制能力随时间变化的曲线,开发者就能清晰地看到模型在上线后的“生命周期”中,能力是稳步维持、缓慢衰退,还是出现了断崖式的下跌。
这种实时追踪基准测试之所以重要,是因为当前的AI市场高度不透明。以Opus 5.5为例,发布时它的各项得分堪称统治级,但在随后的几个月里,用户纷纷抱怨它在某些复杂任务上变得“智障”且回答迟缓。在没有Livenerf这类工具的情况下,这些抱怨只能停留在社区论坛的情绪宣泄阶段。但通过连续的基准测试追踪,你可以直接提取出客观证据:比如,从第三个月开始,Opus 5.5在代码生成准确率上的得分从 85% 掉到了 72%。这意味着厂商可能在幕后更换了较弱的基座,或是收紧了推理深度的资源分配,也就是所谓的“性能削弱”(nerf)。
对于深度依赖大模型API的开发者和企业而言,建立自己的模型监控流水线已经成为一项必要的基础设施。当底层模型能力突然缩水时,它不仅影响用户体验,更可能导致业务逻辑彻底失效。通过持续追踪,技术团队可以:
- 及时预警:在模型能力跌破业务容忍线之前触发警报。
- 横向对比:当某家厂商“削弱”了旗舰模型时,快速测试并切换至其他厂商的替代品。
- 成本核算:将“每解决一次复杂任务的真实成本”与模型能力曲线挂钩,避免为名不副实的低价模型买单。
总之,别再把模型厂商发布的Benchmark数据当成永恒不变的真理。在这个算力与效果随时可能被“偷工减料”的AI时代,掌握持续追踪模型真实能力的能力,才是技术团队保持竞争力的底线。