想象一个药房取药的场景,一台机器人精准探出机械臂,从密集货架里夹起一盒药,转身送到窗口。会看、会听、会动手,这些它都做得到。但还有一个更关键的本领,动手之前先想一步,这样做下去会发生什么。
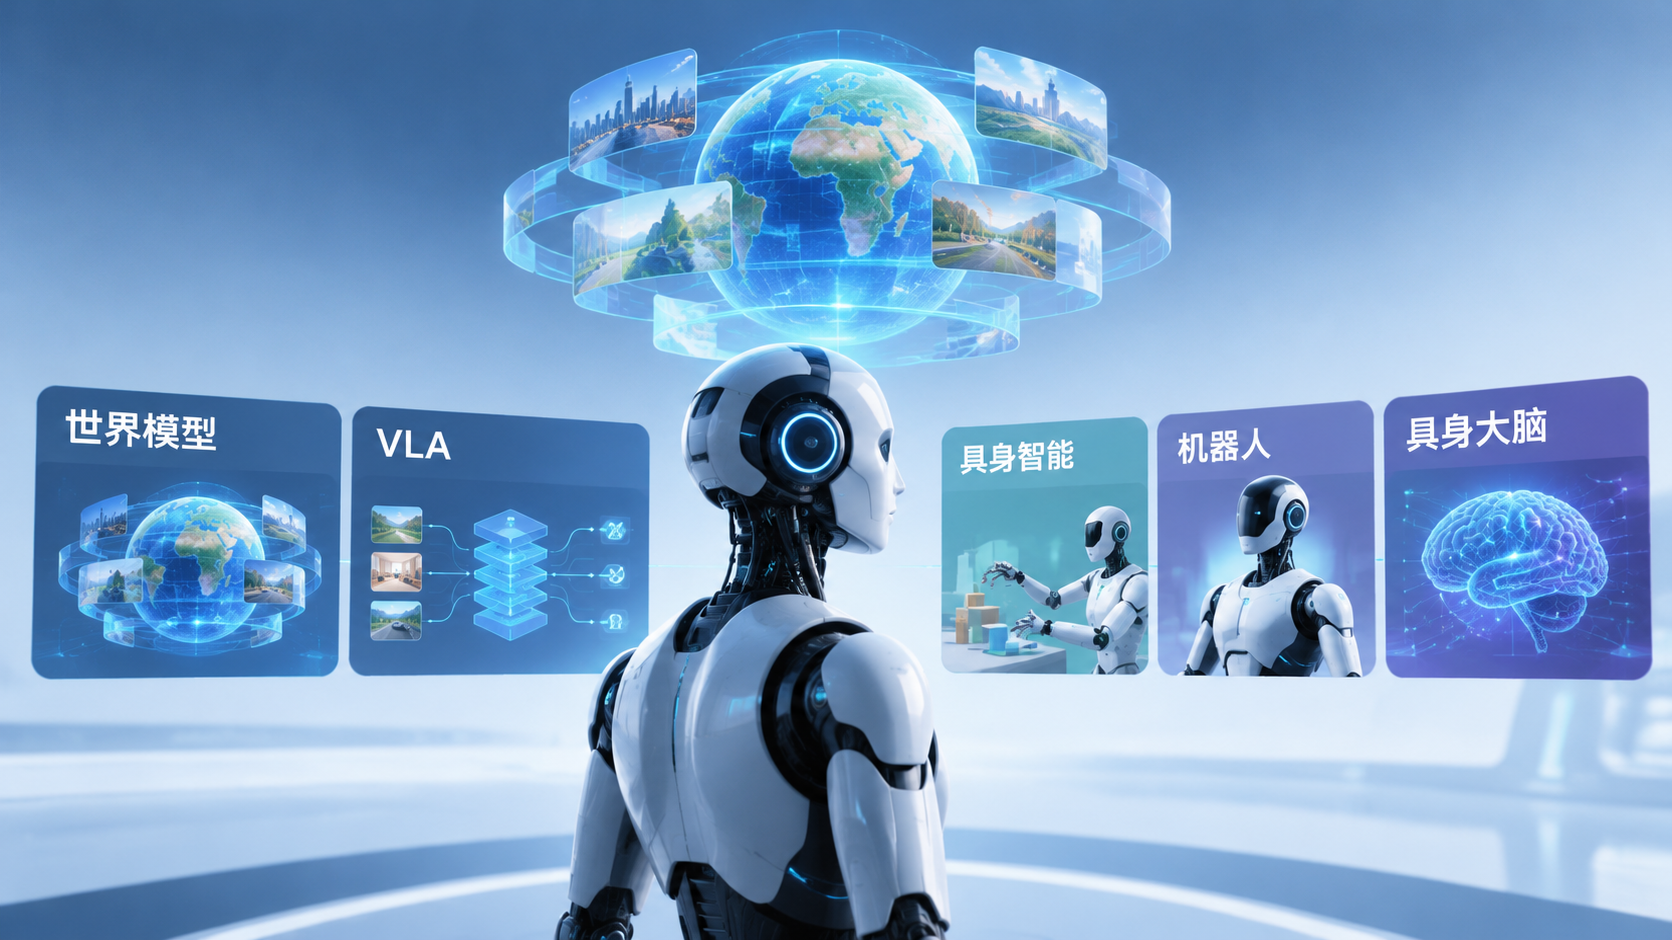
这个听起来很朴素的问题,恰恰是当下机器人圈子里最热的命题。VLA,也就是视觉、语言、动作一体化模型,解决的是机器人能不能把活儿干成。世界模型解决的是更上一层的问题,在脑子里把接下来几秒钟的演化预演一遍,再决定怎么做。一个管执行,一个管预判,两者并不互斥,而是正在快速融合。
蚂蚁灵波把 VLA 送进了上海国大药房的门店,同一个通用大脑适配了 17 个机器人品牌、20 种构型,跨本体、跨任务都能跑。智元则把世界模型和动作生成整合到同一个模型里,训练数据从 300 小时拉到 3 万小时,陌生场景的成功率直接翻了大约 2.6 倍。擎朗智能走的是嵌入式融合路径,把世界模型塞进 VLA,机器人不靠遥操作也能完成咖啡制作这种长流程任务。
但预演未来这事儿,有三个必答题绕不开。第一个是速度,在 RTX 5090 上生成一个连续动作块大约需要 104 毫秒,得够用。第二个是拟真,有的模型能渲染出端水杯的画面,杯子里的水却纹丝不动,这就露怯了。第三个是数据,业内判断能力明显涌现可能要接近千万小时级的训练量。这三关任何一关不过关,世界模型都还只是 PPT 上的承诺。
更值得关注的,是上海这边多条技术路线同时在跑。有人做 C 端货架,机器人在 75 厘米宽的加油站便利店通道里拣选打包。有人扎 B 端产线,在汽车线束装配上连续作业。还有人在实验室里让机器人感知移液的力度与反馈。同一个问题,几套解法并行验证,标准、规划、评测也在同步跟进,世界模型标准已经被列进了 2026 版的国家人形机器人产业标准体系。
坦率的讲,行业现在最稀缺的不是某个单点突破,而是把 VLA 的会干活和世界模型的想得明白真正拧成一股绳。从看懂世界到预演下一步,这一步看起来不大,但跨过它,机器人才算真正有了大脑。
文章来源自量子位,原标题为「从看懂世界到预演下一步,世界模型与 VLA,如何让机器人拥有真正的具身大脑」。
相关文章