## 第三次“跌倒”,暴露了云服务的脆弱性
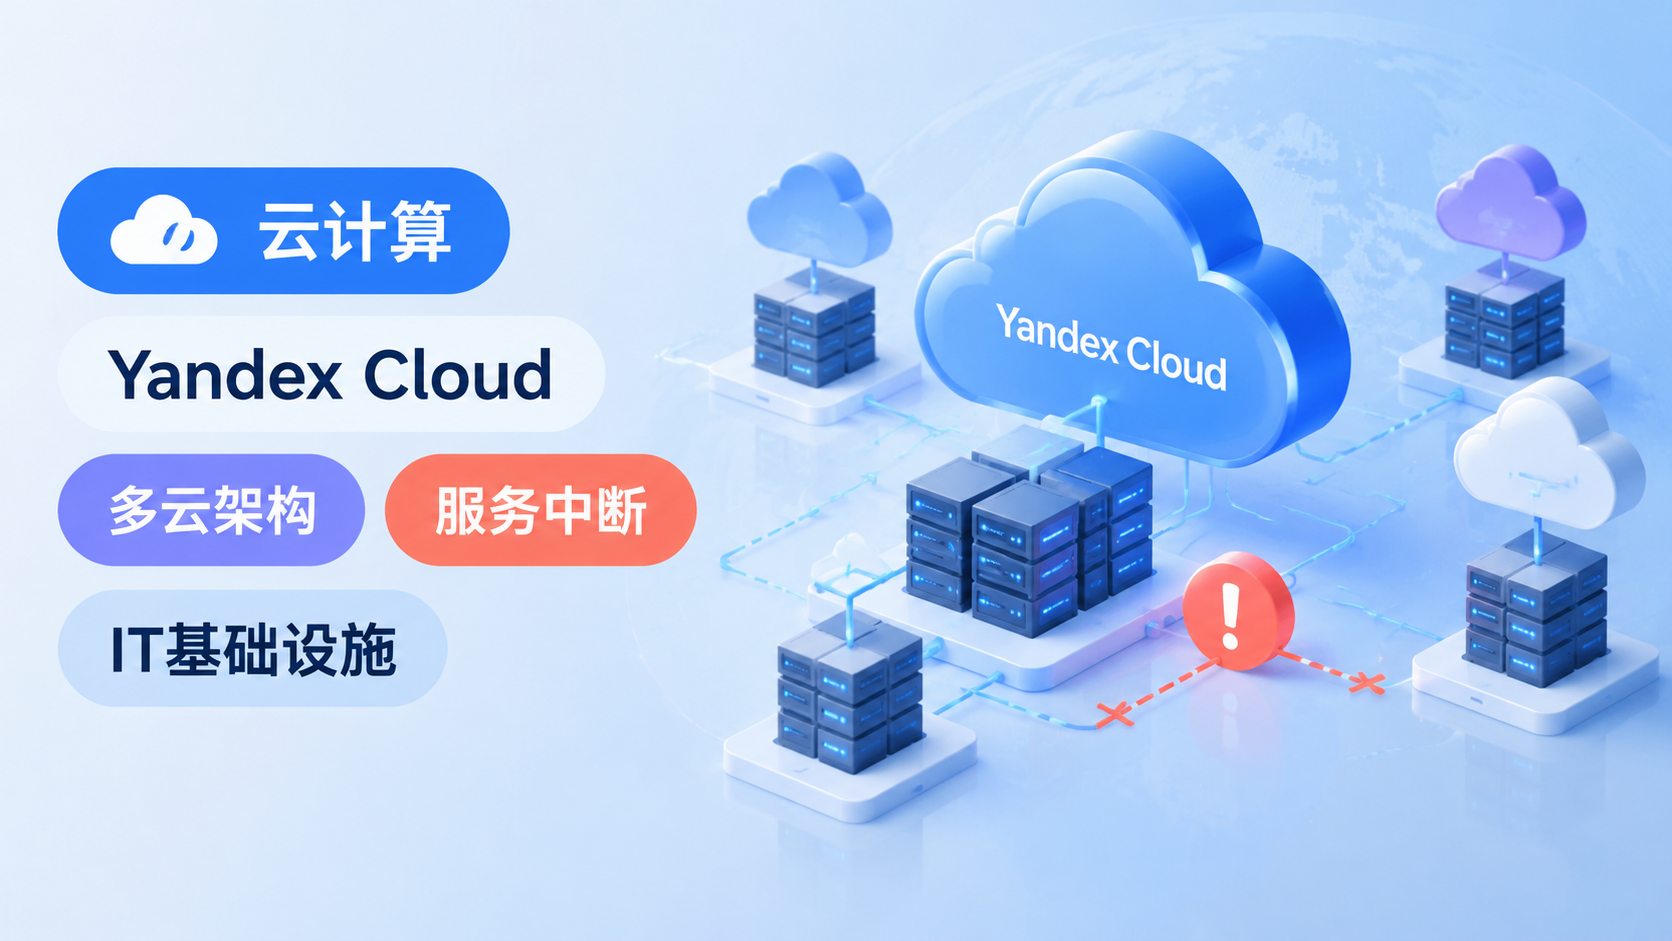
近日,俄罗斯主要云服务商Yandex Cloud再次发布了服务中断公告。这次事件并非孤立个案,而是其近期遭遇的第三起大规模可用性事故。根据状态页面的更新,从10月11日凌晨开始,Yandex Cloud的多个核心区域陷入瘫痪,影响范围极其广泛。受影响的服务清单几乎涵盖了云计算的所有基石组件:从基础的计算实例(Compute)到对象存储(S3),再到身份认证(IAM)、容器注册表以及托管数据库服务。当连API控制台和计费系统都受到波及时,意味着用户甚至无法通过正常界面进行资源管理或查看账单,这种“全面停摆”的状态对于依赖该平台的企业而言,无异于数字世界的“断电”。
## 恢复之路漫长,官方建议“搬家”
值得注意的是,Yandex Cloud在多次更新中并未给出明确的预计恢复时间(ETA),反而反复建议用户“考虑使用替代平台来更快地部署资源并提供冗余”。这一官方表态极具深意:它间接承认了在短期内彻底恢复服务的不确定性,甚至暗示部分基础设施可能遭受了不可逆的损害或需要长时间的重组。对于用户来说,这种被动等待的局面是最糟糕的,因为业务中断的每一分钟都在产生实际的经济损失和用户体验下滑。技术团队虽然宣称正在“全天候工作”,但支持渠道的恢复滞后以及配额发放的暂停,进一步加剧了用户的焦虑。
## 单点故障:企业云战略的隐形杀手
这次事件再次敲响了警钟:**单一云供应商依赖(Single-Cloud Dependency)是架构设计中的重大隐患**。许多企业在迁移上云时,往往优先考虑成本效益和操作便捷性,从而深度绑定某一云平台的专有服务(如特有的AI接口、专属PaaS组件)。一旦该平台发生区域性甚至全局性故障,企业将失去所有的控制手段,陷入“数据锁死”的困境。
真正的云弹性不仅体现在自动扩容,更体现在**跨平台的互操作性与冗余能力**。先进的企业架构应采用“多云策略”(Multi-Cloud Strategy),将核心业务负载分散在不同的云厂商之间,或者至少保留一个热备的灾备站点在异厂商平台。虽然这会带来一定的运维复杂性,但相比于业务停摆的风险,这种投入是必要的保险费。此外,应用层应具备快速切换后端的能力,解耦对特定云厂商SDK的强依赖,利用标准协议(如兼容S3的对象存储协议、Kubernetes标准)来实现资源的平迁,从而在危机时刻拥有“逃生”的可能。
相关文章