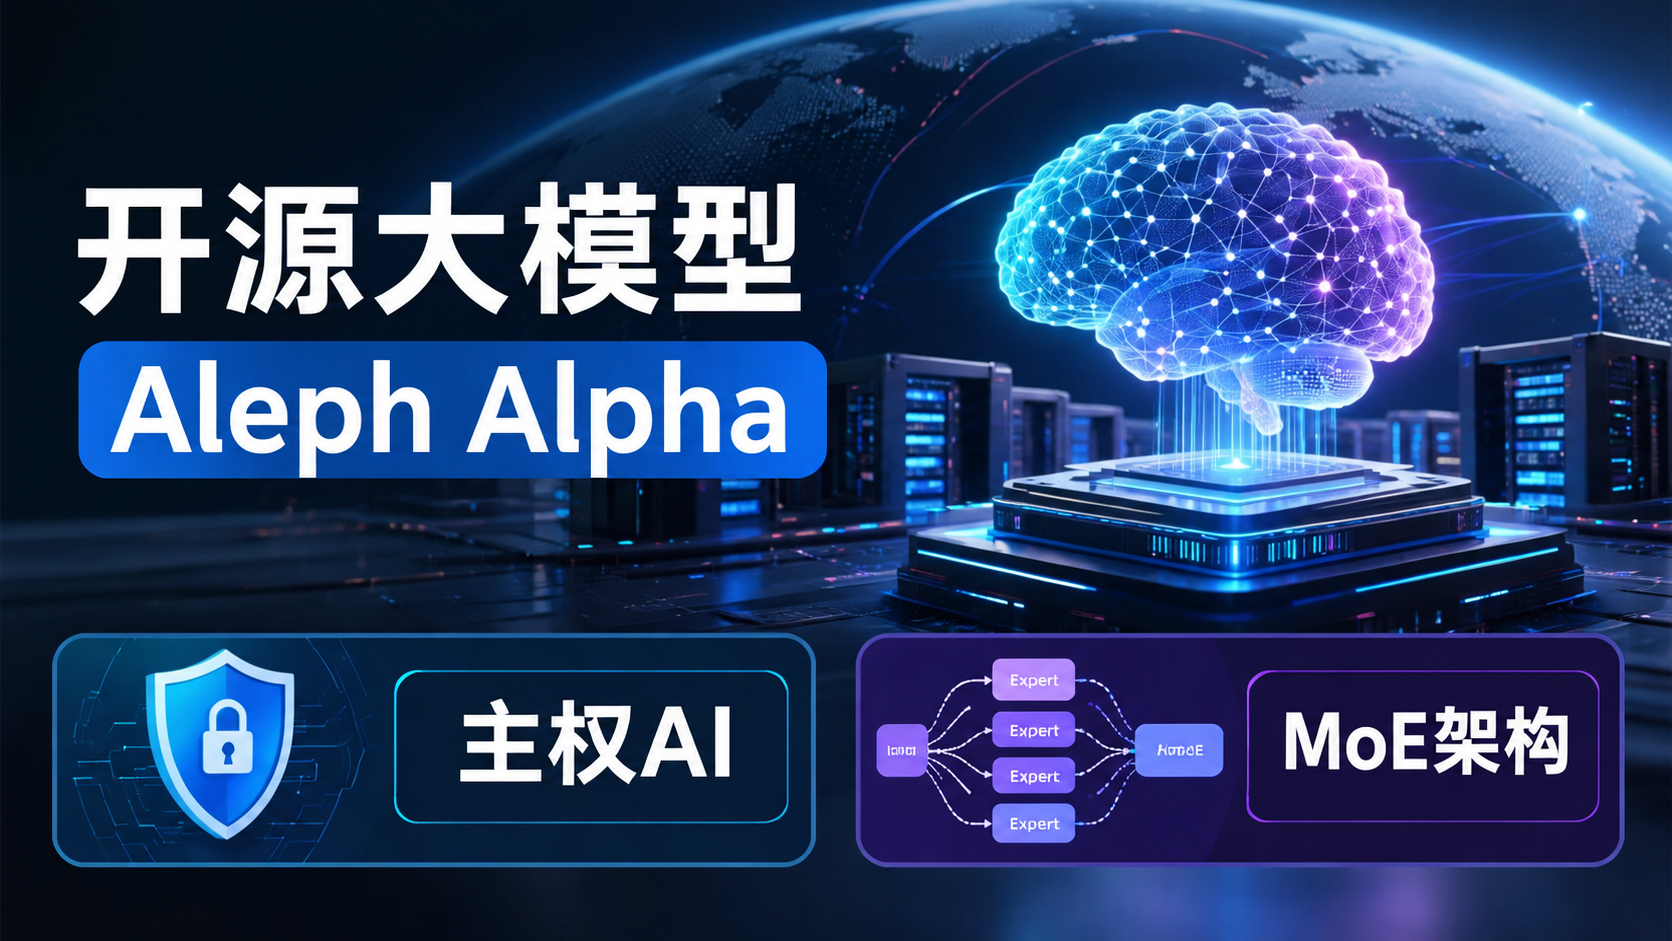
在人工智能日益嵌入政府和企业核心业务的今天,**开源大模型**不再仅仅是一个技术话题,更成为了关乎数据安全与供应链自主的战略议题。德国AI公司 Aleph Alpha 近期发布的新模型 **Kolibri**,正是这一趋势下的代表性作品。这款模型并非追求参数规模的盲目堆砌,而是将“主权”作为核心设计哲学,试图在开放性与安全性之间找到平衡点。
从技术架构来看,Kolibri 采用了混合专家(MoE)Transformer 结构。虽然其总参数量达到了 78B,但激活参数仅为 3B。这种设计显著降低了推理成本,使其更易于部署。更值得注意的是,该模型支持长达 1M tokens 的上下文窗口,这对于处理长篇法律文档、复杂工业指令或大规模数据分析极具价值。Aleph Alpha 选择以 **Apache 2.0** 许可证开放权重,这意味着企业可以完全掌控模型,无需担忧开源协议的繁琐限制,极大地提升了商业灵活性。
与 Meta 的 Llama 或阿里巴巴的 Qwen 等通用模型不同,Kolibri 具有鲜明的**领域特化**色彩。它专门针对英语和德语进行了优化,并在推理、数学及代理行为(Agentic behavior)上进行了强化。其目标市场非常明确:公共管理、工业及航空航天等受严格监管的领域。在这些场景中,模型的可解释性、合规性以及数据隐私往往比泛化能力更为重要。Aleph Alpha 强调,通过专门化训练,客户可以实现可衡量且持续增长的投入产出比(ROI),而不仅仅是获得一个“聪明”的聊天机器人。
**“主权AI”**是这篇技术报告的核心关键词。在这里,主权不仅指模型的所有权,更包含整个训练供应链的完整性。从数据摄入、预训练到后训练,每一个环节都保持透明且可审计。对于担心数据泄露或算法“黑盒”的企业而言,这种端到端的可追溯性至关重要。此外,结合 Aleph Alpha 与加拿大公司 Cohere 达成的跨大西洋合作,可以看出欧洲正在构建独立的AI基础设施,以减少对单一技术供应商的依赖。
然而,挑战依然存在。虽然 MoE 架构提升了效率,但 78B 的总参数对于边缘设备而言依然庞大。如何在保持高性能的同时进一步轻量化,将是后续迭代的关键。此外,开源意味着全球开发者都可以访问这些权重,如何确保模型不被滥用,如何在开放中维持安全底线,是主权AI需要长期解决的悖论。
总体而言,Kolibri 的发布标志着开源大模型正在从“通用竞技”转向“垂直深耕”。它证明了在特定语言和法律环境下,专用模型往往比超大通用模型更具实用价值。对于寻求在合规框架内落地 AI 的企业来说,这或许是一个值得关注的细分方向。
相关文章